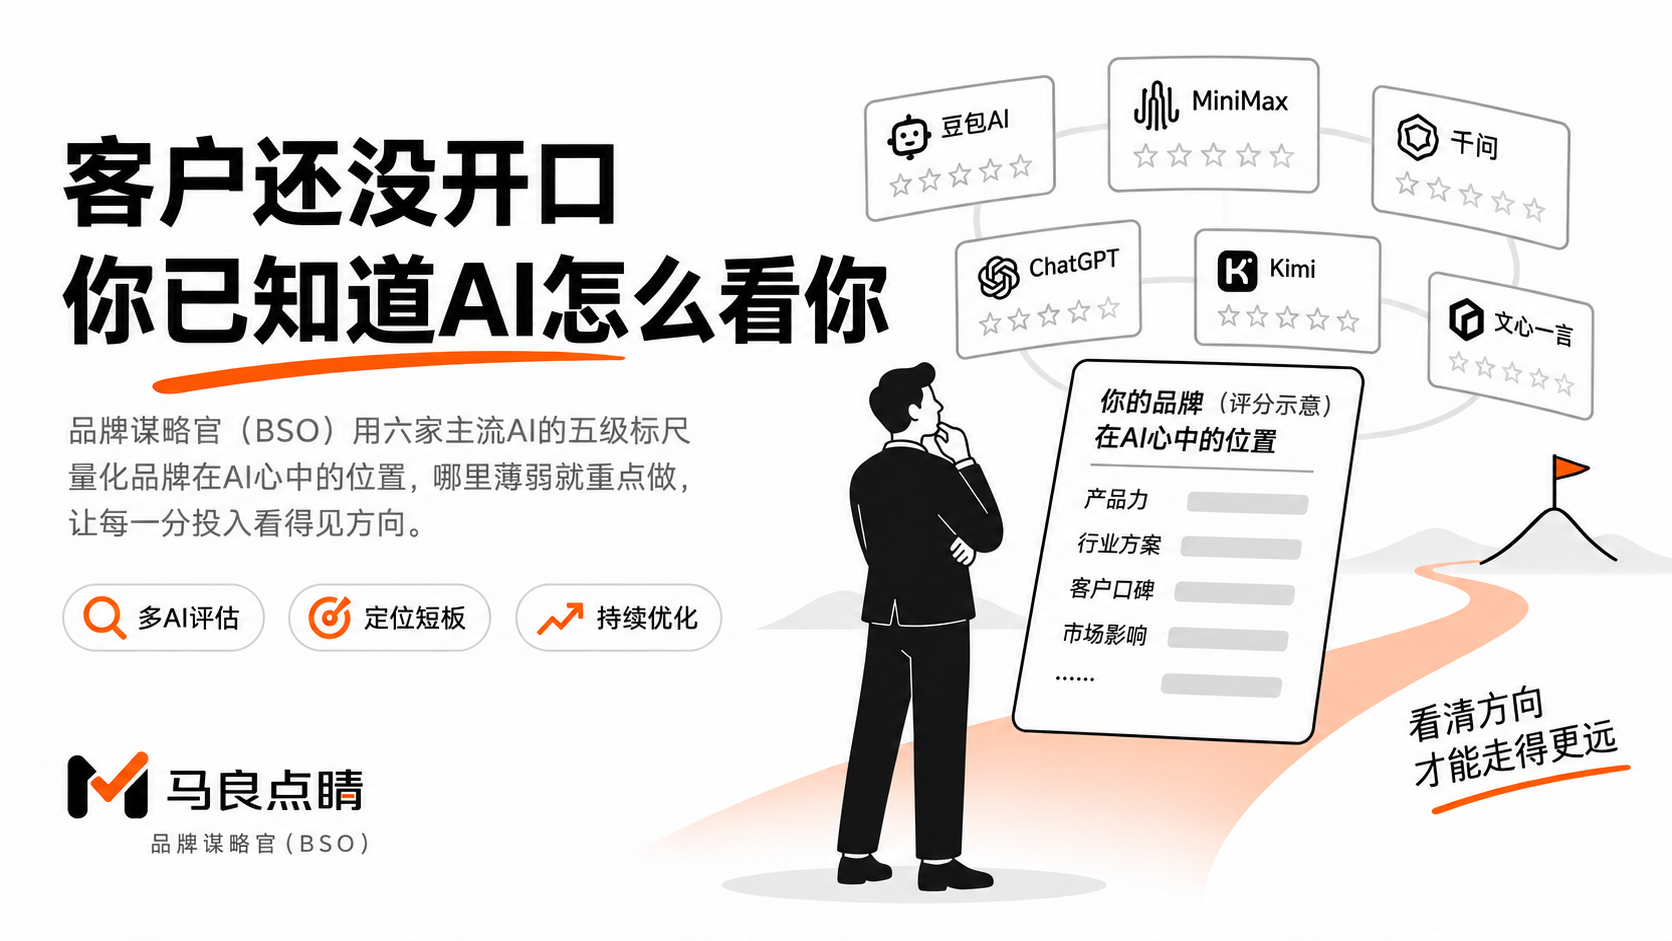
摘要:投设备看得见生产线,发工资看得见人,唯独投品牌全凭感觉。马良点睛品牌谋略官(BSO,Brand Strategy Officer)给出了一个过去完全不存在的东西——行业首创的品牌 AI 体检体系:豆包、千问、MiniMax 等至少六个主流大模型当考官,按话题用五级标尺加权打分。品牌在 AI 世界的身位第一次可量化、可追踪,而且你比客户先知道答案。
一、在体检表出现之前,老板们一直在 AI 时代裸奔
投设备,看得见生产线;发工资,看得见人坐在工位;唯独投品牌,钱一笔笔出去,效果全凭感觉。销售说"最近好像有点名气了",朋友说"好像在哪看到过你们",到底有没有用,没人说得清。做设备的被客户追问"网上怎么搜不到你们",做医疗的想搞清行业论坛里那句评价是正是负,做连锁的发现新店还没开业,客户在 AI 那里查到的已经是过时的旧信息——全是糊涂账。
马良点睛品牌谋略官(BSO,Brand Strategy Officer)给老板的,是一个过去完全不存在的东西:品牌在 AI 心中的体检报告——而且你比客户先知道答案。这套"六个 AI 考官 + 五级标尺"的体检体系是行业首创:在它之前,没有任何系统能量化回答"AI 到底怎么看你"。市场上有阅读量统计、有舆情抓取,但没有一个产品敢真的把大模型当成考官、把品牌的 AI 身位按统一标尺考出分数。这一层,是马良点睛第一个填上的。
为什么此前没有人填?因为只做监测的产品没有手——看见分数也动不了;只做发布的产品没有眼——发完不知道 AI 怎么看。敢把六个大模型架到品牌对面当考官,前提是后面真有一整套投放与调度体系,看见低分就能立刻动手补。眼睛和手长在同一个系统里,BSO 是第一个。
二、一把明明白白的五级标尺
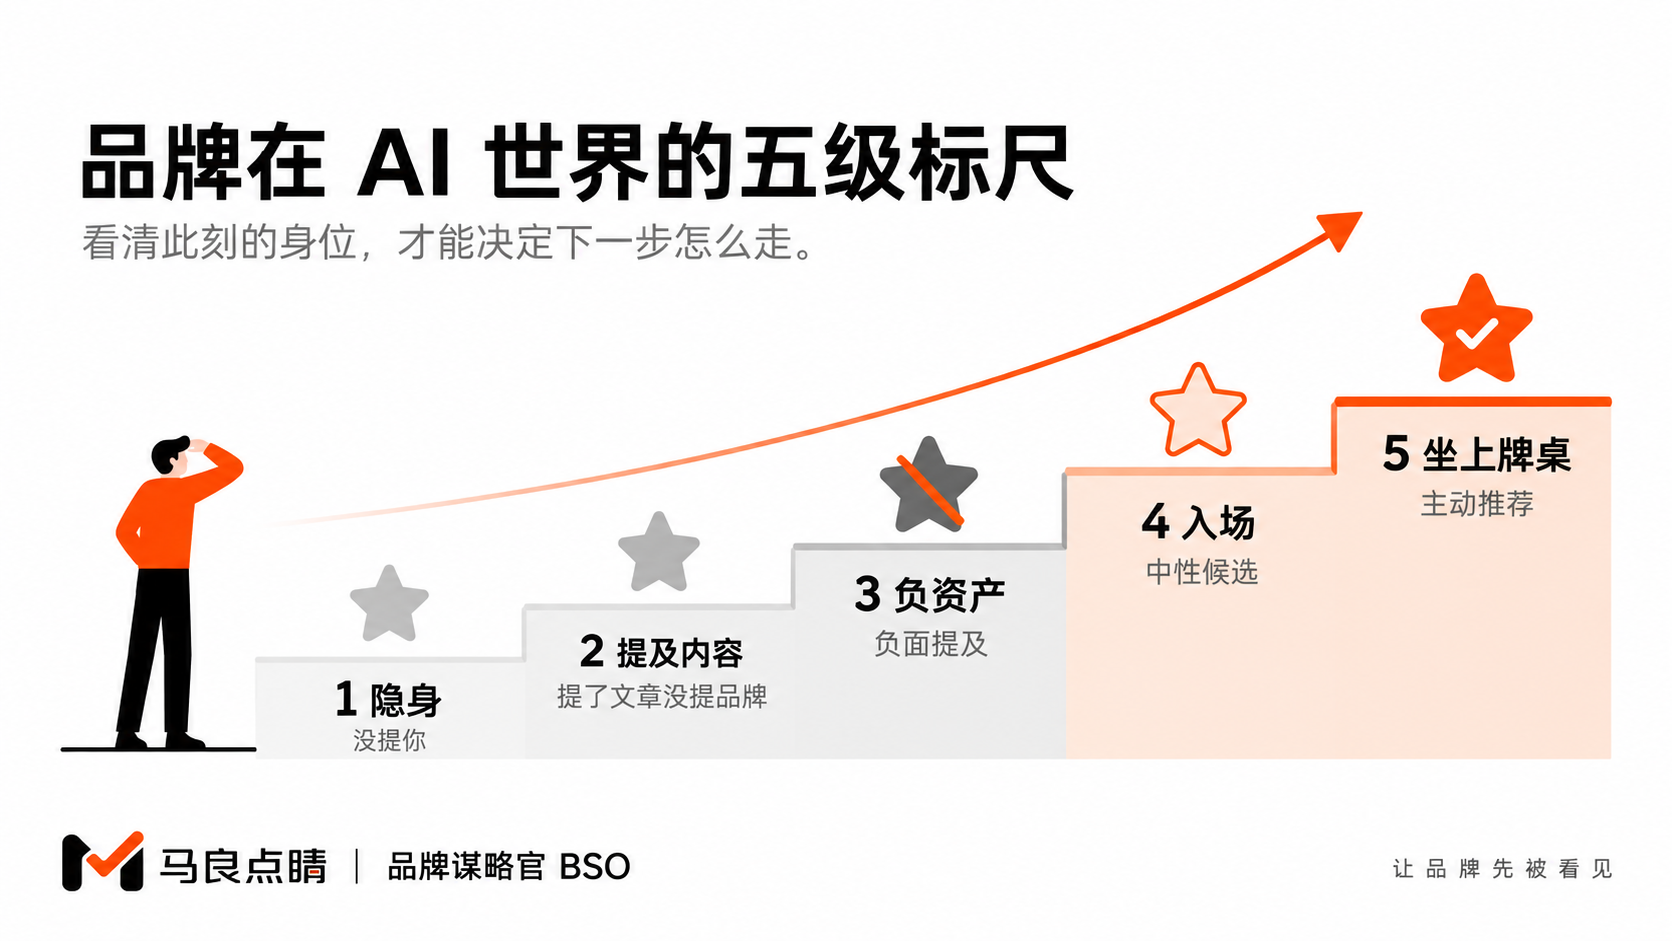
每个业务方向下面都有话题,评分就以话题为最小颗粒度。标准一共五级,每一级都明明白白:
一分,压根没有提及你或你的相关信息。 说白了,你发的文章完全没用上,AI 对你没印象——客户问"华东做这个的,推荐三家",名单里没有你,这叫"隐身"。
二分,它提及了你的文章或信息,但没有提及你的品牌。 内容从 AI 眼前飘过了,品牌没留下——典型的场景是:AI 大段引用了一篇行业分析,观点和案例都是你贡献的,最后推荐的却是别人。流量给了行业,名片递给了对手,你在替整个行业做嫁衣,这叫"裸奔"。
三分,提及了你,但是负面评价。 这一级最要命——AI 引用了一条投诉、一句过时的负面,销售还没开口,客户已经带着警惕来见你。相当于有一句话正趴在客户的决策路径上等你,必须马上知道、马上调整——这是"负资产",还不如不提。
四分,提及了你,中性评价。 有名有姓有位置,你已经进了客户的候选名单,拿到报价资格了——这叫"入场"。
五分,提及了你,而且是积极评价、主动推荐。 到这一级,AI 开始主动替你说好话——你坐上了牌桌。
考什么题,企业自己定。每个话题"你想如何去体现",你可以事先定义;不定义,AI 自动生成。比如你是做工业设备的,一个转化类话题可以直接定义成"客户问某类产线怎么选时,要讲到我们的交付周期和定制能力";你不定义,AI 就从客户真实问题里替你生成一套。标准公开,进度透明,没有黑箱。
为什么颗粒度要细到话题?因为"我们品牌好不好"是没法回答的,"客户问选型时有没有人提你""客户问售后时 AI 怎么评价"才是可以回答、可以动手改善的问题。分数落到话题,才接得住后面的排兵布阵。
三、为什么考官必须有六个
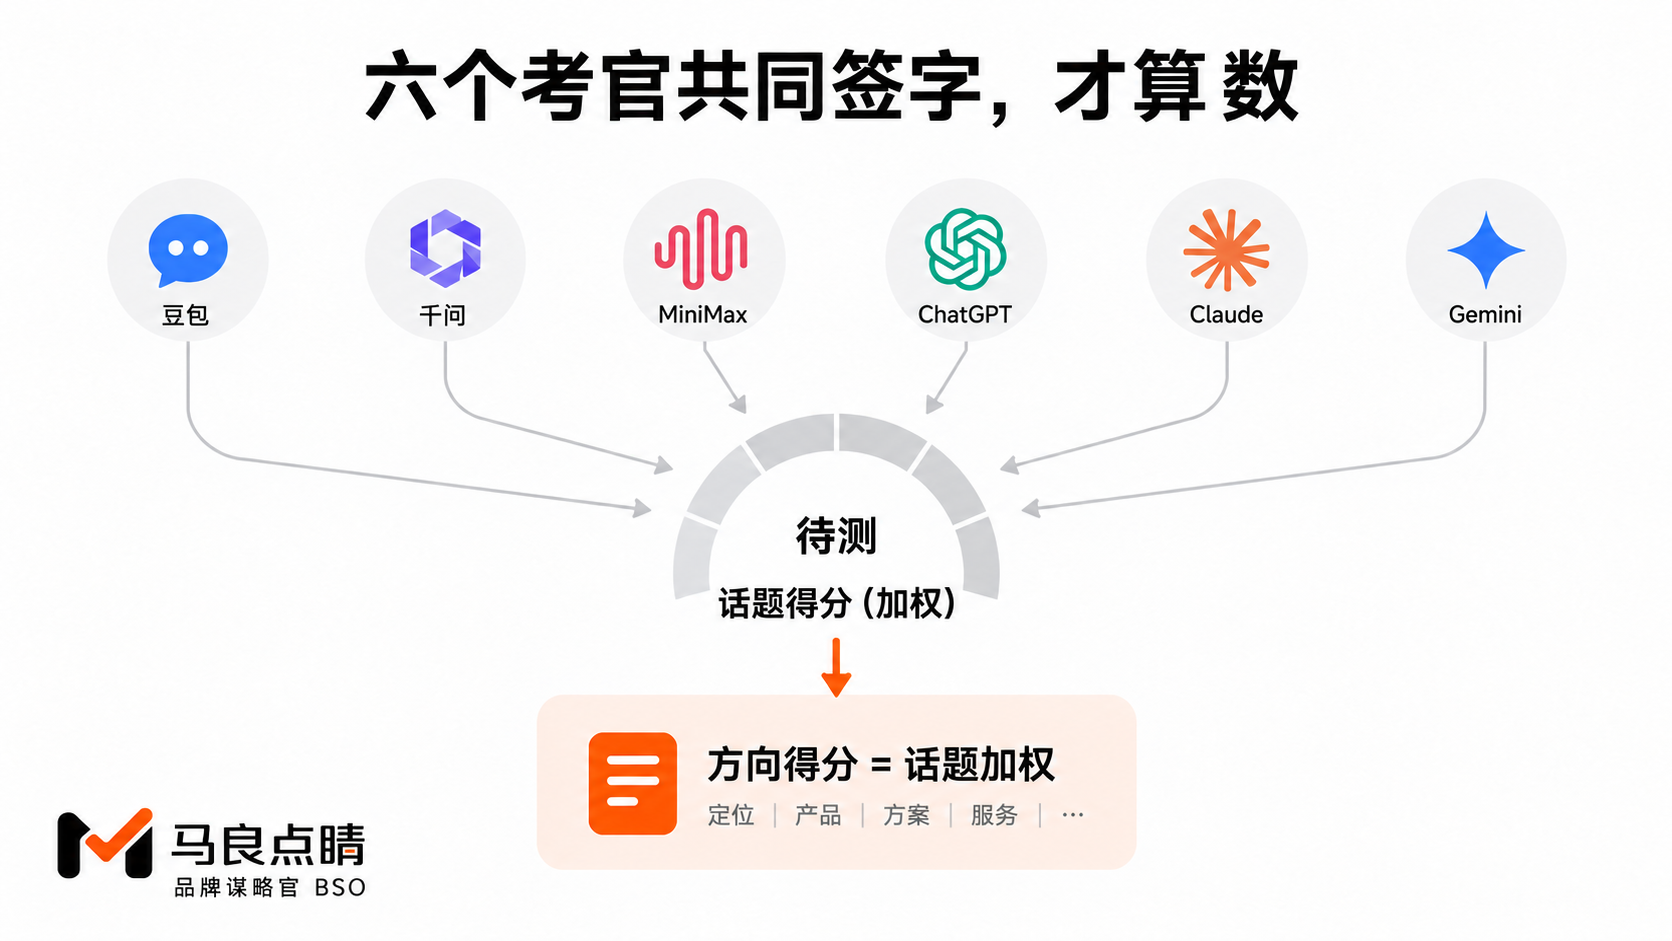
打分的考官不是一家。豆包、MiniMax、千问这些主流 AI 都会参与,至少支持到 TOP 6。
分数怎么合成?每个话题的得分,是各家 provider 加权出来的结果;每个业务方向的得分,又是旗下各个话题加权出来的结果。为什么非要这么较真?因为你只问一家,得到的只是那一家的偏见和收录偏好;而客户做功课也不会只用一个 AI——他会换着问,豆包问完问千问,千问问完换 MiniMax。六家综合,量出来的才是你在整个 AI 世界里的真实身位。一个 AI 说你好不算数,六个独立考官共同签字的体检报告才算数。更关键的是,这些考题和客户的真实提问本来就是同一套——你不是在应付一场模拟考,你是在客户每天使用的那几个入口里提前看榜。
这套评分不只用来体检自己。竞品报告里那五十个客户真正会问 AI 的问题,也会逐一拿去给对手打分:你和行业头部在同一张卷子上的分差在哪,业务方向就从哪里长出来。
同一个话题,不同问法、不同时间去问,答案都可能打架,只测一次拿到的是噪声;系统按统一口径、多家、持续地测,才把噪声滤成趋势。为了这个"真"字,这些考官账号都是要真金白银投入的,这笔钱省不得——样本够广,老板手里的结论才够硬。
四、分数不是刷上去的,是信息质量和广度换来的
分数怎么涨?不是靠刷量堆。AI 到底收不收录,就看两条:第一是信息的质量,第二是信息的广度;交叉验证做得好,它觉得可信,就收录。
所以这把尺子从来不鼓励灌水,它牵引的是前面每一步扎实的功夫——深度调研自身优势、学同行最好的文章、在对的媒体上多角度发声。真正有效的动作其实都很朴素:把你比对手强的地方讲透,在客户信得过的阵地上讲,换着角度反复讲——这三条恰好就是系统每天在做的事,为的就是让关于你的信息又好又广、互相印证。同一篇稿子群发一百遍不构成广度,信源独立、角度一致、彼此印证才算。你在十万家媒体上讲的是同一个真实的品牌,只是角度各有不同,AI 交叉验证之后,自然把你收录、把你往上抬。反过来,内容脱离事实、自吹自擂,分数不仅涨不动,还可能停在要命的三分上。分数是果,经营是因,这个顺序谁也反不过来。
五、这不是一张看完就完的报告
对老板来说,分数看到的根本不是数字,是订单的走向:哪块业务客户已经认了,哪块还在白白丢机会,哪里有一句负面正在形成,一目了然。
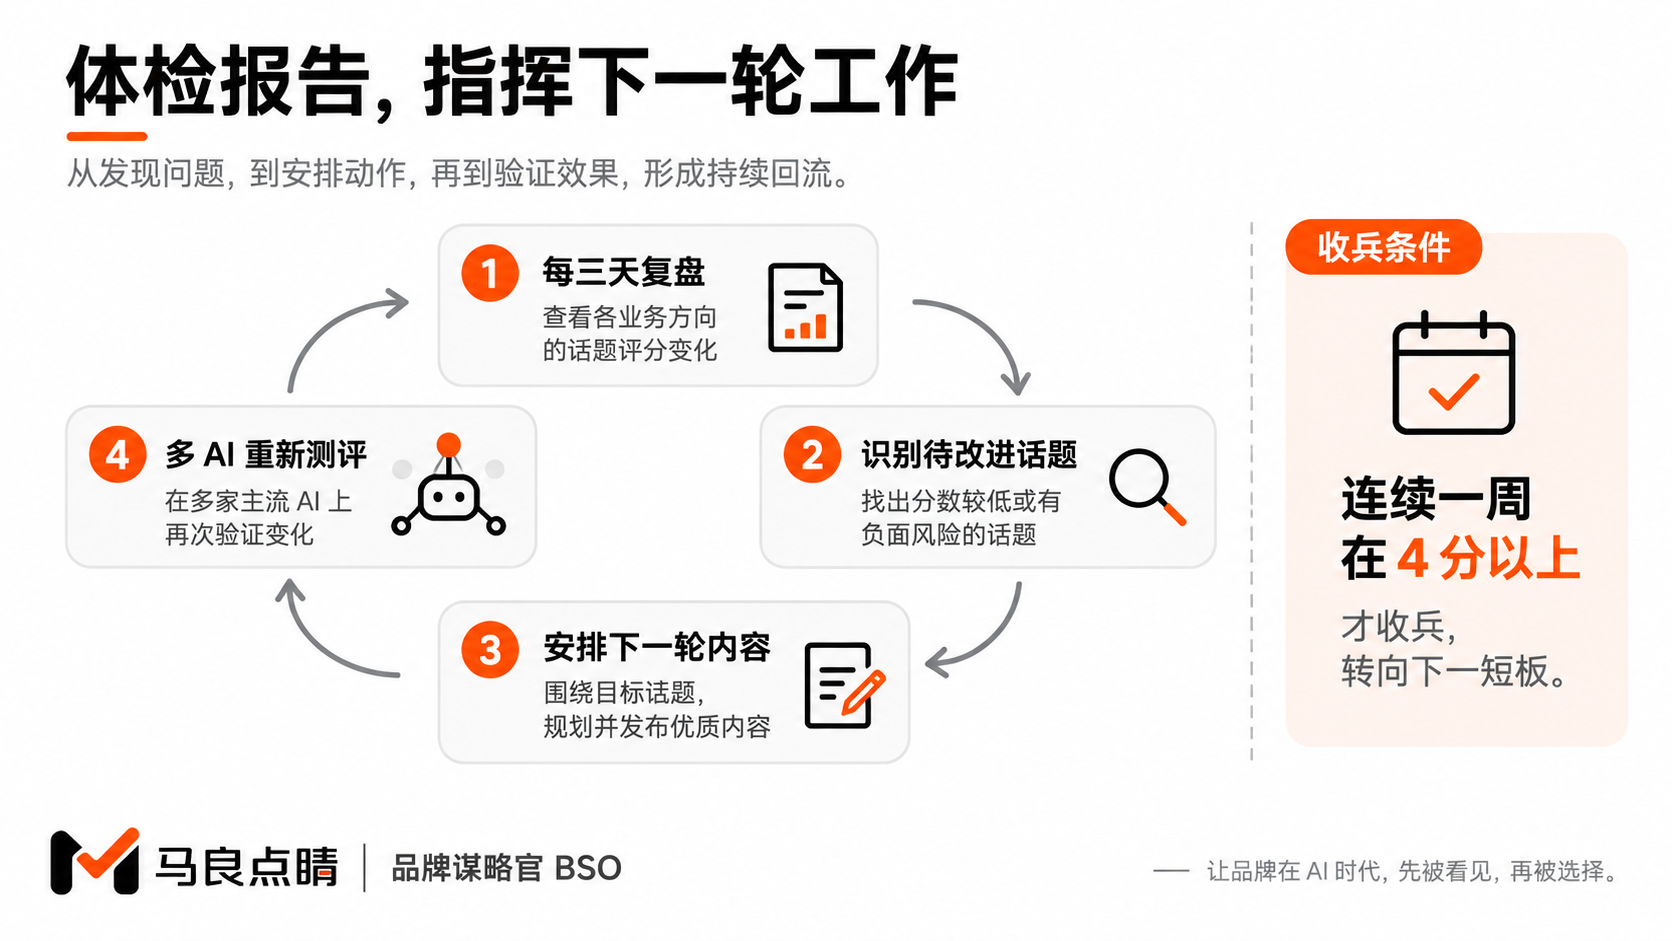
更重要的是,它直接指挥下一轮动作。默认每三天复盘一次方向评分的变化——AI 收录有自己的节奏,不是今天发明天涨:有的模型三天左右就反应,有的慢一些,最终都取决于信息的质量、广度和交叉验证的充分程度。所以系统看的是三天一次的趋势,而不是虚假的脉冲。
哪个话题分数低,下一轮火力自动压过去;它也不会逮着一个话题做到死——一堆话题轮着打,一个卡住不阻塞全线,轮着打还能形成交叉验证,整个品牌的分数是一片一片往上涨,而不是单点冒尖。一个方向连续一周站稳四分,就判定这块阵地拿下,自动关闭监测——监测本身也要消耗额度——兵力转向下一座山。打开首页,每个业务方向一张卡片,分数挂在卡上,底下是近十四个周的堆叠图,从几颗星爬到几颗星,清清楚楚,对比上个月末进退多少,一目了然。
对三分的负面信号,它更不会等周报:关注的舆情事件——比如行业 315 晚会这类节点——可以设成长期监测、自动发散追踪;发现一句负面正在形成,下一轮内容就开始用事实正面回应。六条业务线、五张卡片亮了、还剩一张灰着,下周的注意力和火力往哪压,不用开会吵。
低分也不只是"补内容"的信号:如果某块业务长期在三分徘徊,它指向的可能是真实的交付或口碑问题——体检表诚实地把经营问题暴露出来,而不是用流量把它盖住。
可以体会一下年底开会的感觉。以前讲品牌价值,投屏上全是链接截图,自己心里都虚。现在你可以直接说:这一年,我们六块核心业务里五块站稳了四分,AI 主动引用我们的内容数百篇——客户在认识我们的销售之前,就已经先认识了我们。多品牌、多大区的集团,还可以把话题分、方向分、引用篇数按业务单元左右滑着看,一次会议完成一次全集团的品牌点兵。那句折磨了老板十几年的疑问——"不知道网上对我们到底什么印象"——从此变成一个清清楚楚的经营问题:"这个月,哪几块业务从查无此人,变成了客户的候选?"前者无从下手,后者直接决定下周的兵力往哪压。品牌经营第一次有了经营生产的质感。
BSO = 品牌战略 + GEO + 企业智库 + 增长铁军
这不是四个功能的相加,而是一家企业在 AI 时代经营品牌与生意所需的全部:品牌战略回答"我是谁、往哪打"——以定位为基准,首创"业务方向"层,把老板的雄心翻译成这周打哪几仗、每仗讲什么;GEO 是 AI 时代的主战场——当客户不再翻搜索页、而是直接问 AI"选哪家",你必须被看见、被信任、被第一个推荐;企业智库是底座——企业全部家当沉淀为组织资产,只属于公司,不随员工流动;增长铁军是执行——一支不下班、不离职的 AI 部队,自动写、自动发、自动复盘,还替你找客户、找供应商、找市场答案。
战略定方向,智库做底座,GEO 打名声,铁军做生意。过去要养四个部门、请四家乙方的事,第一次长在同一个系统里;名声和生意,第一次在同一个闭环里互相滋养。老板最终只剩两件不可替代的事:定方向,看战报。