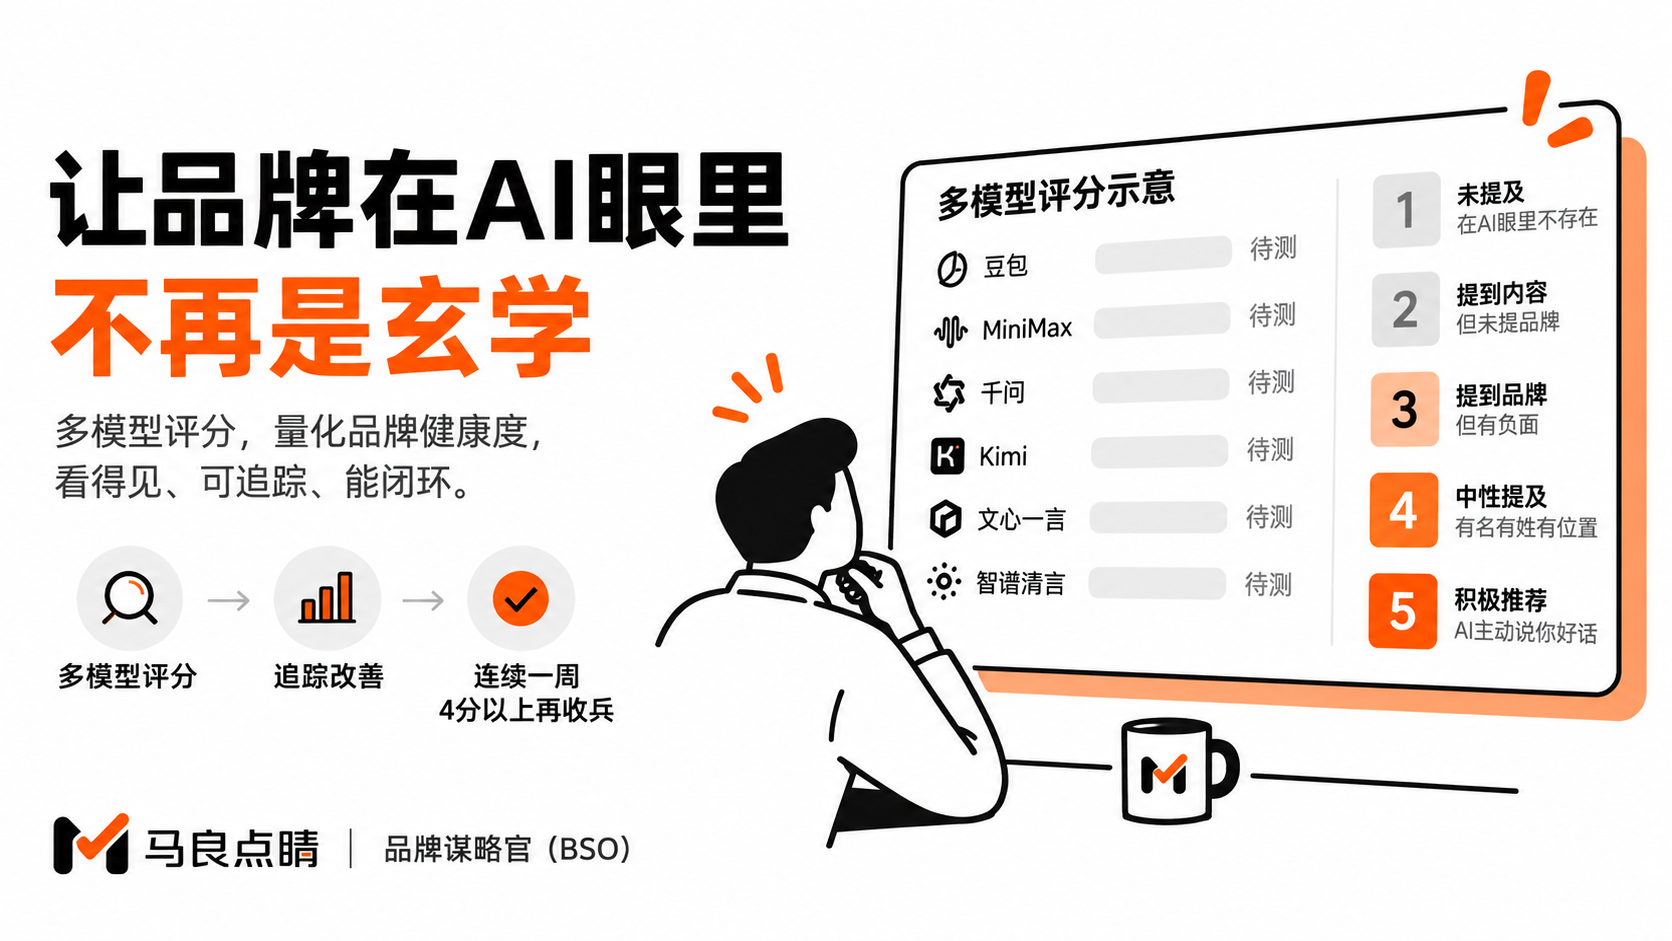
摘要:客户见品牌之前,已经先在豆包、千问、MiniMax 们那里问过一圈了,可老板根本不知道 AI 到底怎么说自己。马良点睛做了一件行业里从没人做过的事:把"品牌在 AI 眼里什么样"变成一把可量化、可追踪、可改善的尺子——至少六个主流大模型同时当考官、独立打分、公开加权,五级标尺每一级都是直白的生意信号,连续一周站稳四分即判定达标。这是 AI 时代品牌体检体系的首创。
品牌健康度,长期是一门玄学。
过去老板想知道品牌做得好不好,看什么?看销量?销量受价格、渠道、季节太多因素影响,不全是品牌的功劳。看曝光量?刷量产业比你还积极。问市场部?大概率报喜不报忧。
而今天,情况又变了:客户在见你、在点进你官网之前,往往先去问了 AI——"某某行业哪家公司靠谱?""某某产品该怎么选?" AI 嘴里有没有你、怎么说你,直接决定了客户会不会给你机会。可偏偏对这件最要命的事,老板两眼一抹黑。
马良点睛团队做了一件行业里从没有人做过的事:把"品牌在 AI 眼里到底是什么样",变成了一把可量化、可追踪、可改善的尺子。 这把尺子叫五级评分标尺,背后站着至少六个 AI 考官。它就是 AI 时代品牌体检体系的首创。
一、五级标尺:简单到老板看一眼就懂
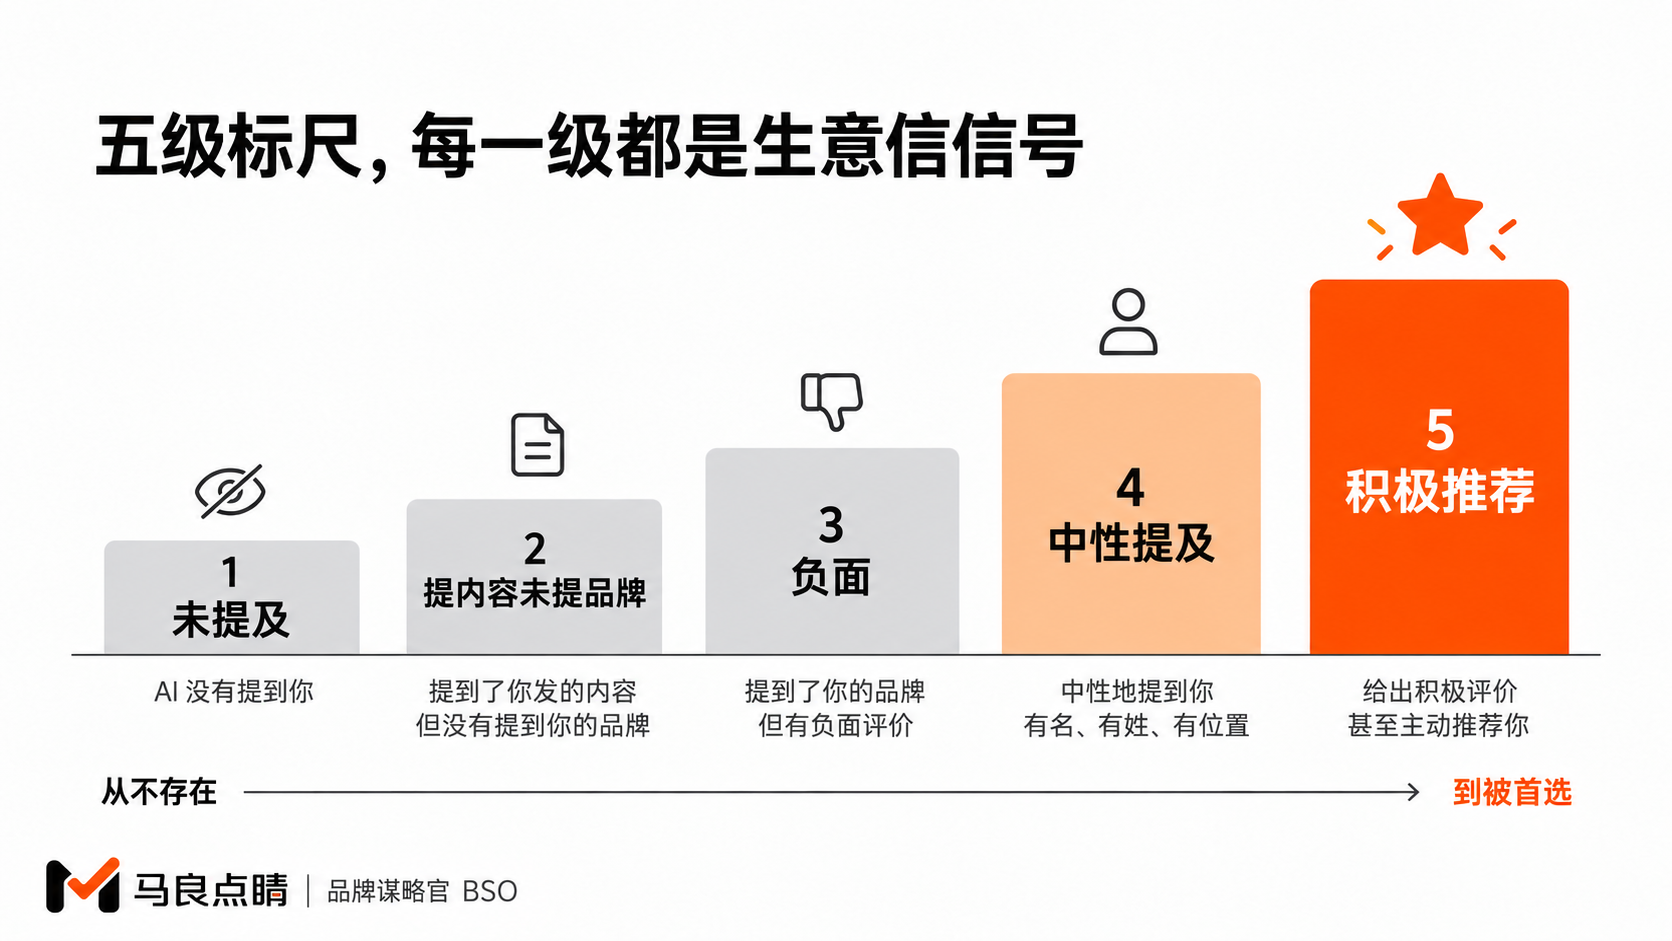
这把尺子没有任何理解门槛,从一到五,每一级都对应一个赤裸裸的生意信号:
- 1 分——隐身。 AI 压根没有提到你。你辛辛苦苦发出去的内容,它完全没用上,你在客户的决策世界里根本不存在。
- 2 分——裸奔。 AI 提到了你发的文章、你贡献的信息,但没有提到你的品牌。等于你在替整个行业做嫁衣,客户记住了知识,记不住是谁说的。
- 3 分——负资产。 AI 提到了你的品牌,但是负面评价。这种情况还不如不提。
- 4 分——入了场。 AI 中性地提到你,有名、有姓、有位置。客户问起这门生意,你稳定地出现在答案里。
- 5 分——坐上了牌桌。 AI 给出积极评价,甚至主动推荐你。
五级之间不是模糊的好感度差异,而是企业在 AI 这个全新渠道里从"不存在"到"被首选"的完整身位。老板不需要懂任何大模型原理,看分数就知道自己的品牌此刻是在裸奔,还是已经上桌。
二、六个考官:谁也别想一言堂
更开创性的是考官机制。
只问一个 AI,就算它说你好,也不算数——万一它的训练数据有偏呢?万一它某一天算法一抖、评分跳水呢?单个平台的结论,当不了经营依据。
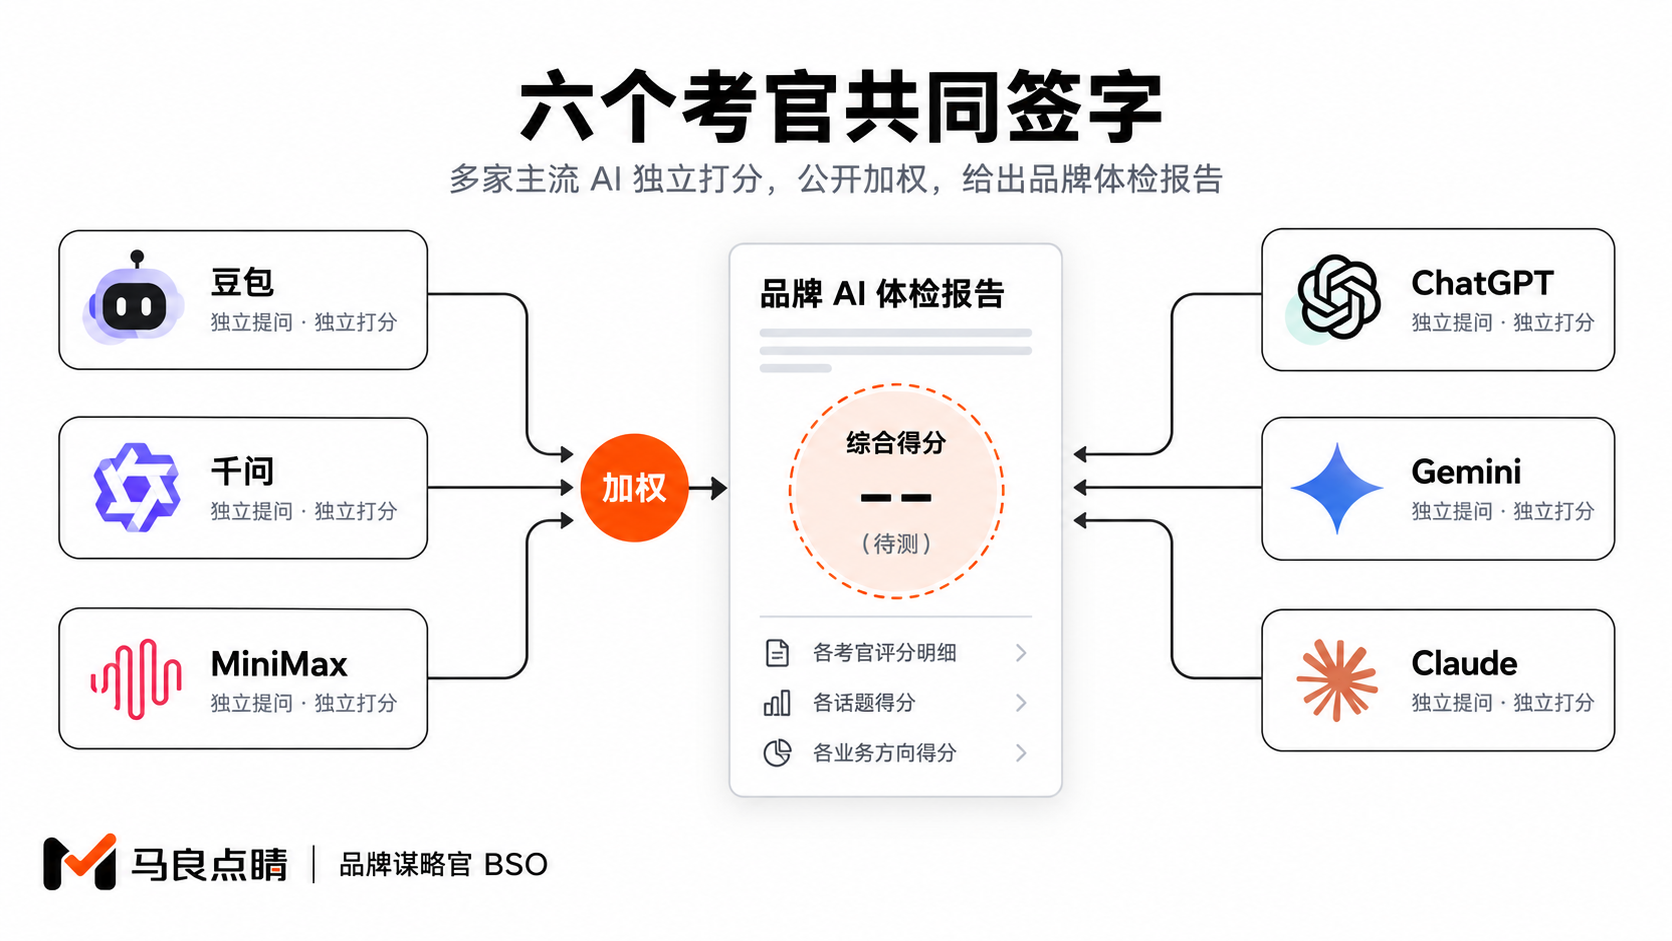
BSO 请的是豆包、MiniMax、千问等至少 TOP 6 的主流大模型同时出场,针对同一批问题独立提问、分别打分,再公开加权汇总。
合成的逻辑是严谨的两层:单个话题的得分,由六个 provider 的回答加权而成;单个业务方向的得分,再由它下面各个话题的得分加权而成。六个考官、各自独立、规则公开,谁也别想一言堂,也从根上杜绝了任何单一平台算法波动带来的误判。
最后老板拿到的,不是一句"感觉还不错",而是一张六个考官共同签字的体检报告:哪个考官认可你、哪个还没收录你、哪个话题已经翻身、哪个方向依然隐身,清清楚楚。
为什么"多个考官"这件事如此关键,值得再多说一层。今天的主流大模型,训练数据来源不同、更新节奏不同、对同一行业的偏好也不同:有的对技术文档敏感,有的更采信权威媒体和行业站点,有的收录快、有的反应慢。只押注其中任何一个,都等于把品牌的判断建立在单一平台的脾气上——它一次算法调整,你的分数可能毫无道理地跳水。六个考官独立出场、公开加权,抹平的正是这种单点偶然性。对老板而言,这背后还有一层朴素的安全感:你看到的结论不是某一家公司想让你看到的,而是六套相对独立的认知系统交叉验证后的共识——这和做重大决策时多听几个独立信源,是同一个道理。
三、"什么时候算好":达标收兵,不恋战
这套体检还顺手解决了一个管理上的终极哲学问题:品牌这件事,做到什么程度算好?满分吗?
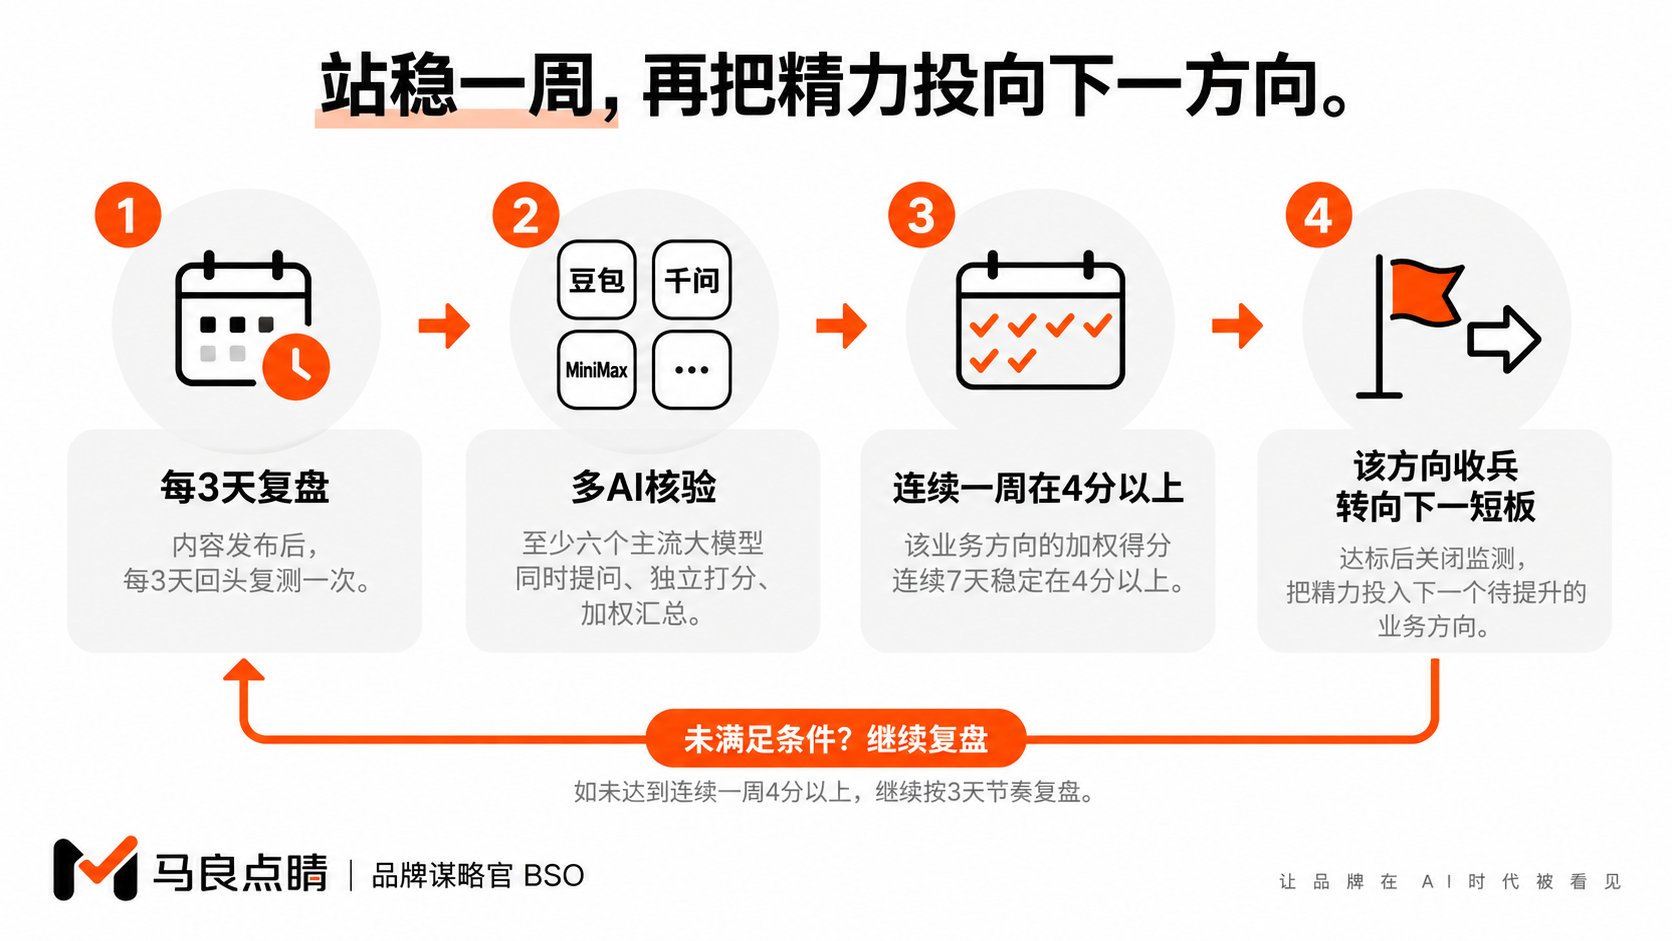
BSO 的答案干脆利落:一个业务方向连续一周稳定在 4 分以上(更高要求可设 4.5 分),这个方向就算完成,监测自动关闭,火力转去补下一个短板。
这是一条极其实在的经营纪律。4 分意味着:客户在 AI 那里问起这门生意,你已经稳定地、有名有姓地出现在答案里——对绝大多数行业来说,这就够了。它不追求虚荣的满分,不在已经站稳的战场上恋战,因为监测本身也要消耗流量和额度。用内部的话说,这叫"站稳四分就收兵,省下的弹药打下一座山"。
四、一把尺子,让品牌第一次成为可科学管理的事
这套体检体系真正遥遥领先的地方,在于它让品牌工作第一次具备了科学管理的三个前提:有指标、可测量、能闭环。
在 BSO 的调度节奏里,每一篇内容发出去,三天后系统就回头去问 AI:分数变了没有?哪几个考官涨了、哪几个还没动静?哪个业务方向正在从 1 分往 4 分爬?每个方向的卡片上还画着近十四周的堆叠曲线,从几星涨到几星,一目了然。
于是,广告界那句流传了上百年的自嘲——"我知道我的广告费有一半浪费了,但我不知道是哪一半"——第一次有了解法。分数会诚实地告诉你:哪一半响了,哪一半没响;哪一类内容真的被 AI 采信,哪一类纯粹石沉大海。品牌投入从此从一门凭感觉的玄学,变成了一张能复盘、能归因、能持续优化的作战地图。
这也正是它和所有"只发不管"的服务商最根本的分野:别人把文章发出去就结束了,BSO 的文章发出去,体检才刚刚开始。
五、为什么这件事别人做不出来
一个可量化的品牌体检,听上去不难,为什么此前没有产品做?因为它单独存在毫无意义——能体检,却不能开药方、不能去治,最后只会变成一张让老板焦虑的报表。
BSO 的体检之所以成立,是因为它长在整套体系的闭环里:评分低,业务方向层知道该补哪个话题;内容层知道该写什么;媒体层知道该往哪些 AI 真正在采集的平台投;调度层三天后自动回来复测。体检、诊断、治疗、复查,是同一个系统里的一条连续回路。 单点工具能抄走一把尺子,但抄不走尺子后面这整套让分数真正涨起来的器官。这就是体系和功能的差距。
六、体检报告长什么样:从一个分数,到一张作战地图
一个孤立的分数意义有限,真正值钱的是分数被拆开之后的样子。
在 BSO 的首页,老板看到的不是干巴巴的一个总分,而是一整张能直接指挥行动的作战地图:名下每个业务方向是一张卡片,卡片上标着这个方向当前的加权得分,下面画着近十四周的堆叠变化曲线——它是从几星一路爬上来的,还是长期在两分原地踏步,趋势一目了然;点进方向,里面是一个又一个话题,每个话题各自挂着六个考官的原始判定。
于是"品牌不好"这种模糊焦虑,第一次被拆成了可以逐个击破的具体任务。比如一家做医疗设备的企业体检后可能看到这样的画面:"术后维保"这个话题总分 4.2、六个考官全部到位,已经达标;"进口替代选型"这个话题只有 2 分——再往下钻,发现豆包和千问其实引用过企业发的技术文章,却始终没提品牌名(典型的两分,在替行业做嫁衣),而另外几个考官压根没有收录;再看同行业的对手,恰恰在这几个考官那里长期有内容。问题出在哪、该补哪个话题、该往哪些 AI 真正采集的平台投、这一轮火力该往哪压,报告已经替你把方向指到了话题颗粒度。
三天后系统自动复测,这张地图就刷新一次:哪个考官被新内容撬动了、分数有没有动、曲线是不是抬头了,全部留痕。连续一周稳定过线,话题卡片自动翻成"已达标",监测关闭、火力转移。老板要做的,只是隔几天花三分钟看一眼这张地图,在真正需要他拍板的地方给一个 push——这正是"人在环中"最理想的样子:机器负责不知疲倦地测量、执行和复查,人负责判断方向和做创造性决策。
对比一下旧世界:年底找代理要一份舆情报告,几十页 PPT、数据真假难辨、看完也不知道下周该改什么。BSO 的体检不是一份用来汇报的文档,而是一个和内容生产、媒体投放、火力调度长在一起的活体仪表盘——这也是它和市面上所有"一次性品牌诊断"最本质的代差。
BSO = 品牌战略 + GEO + 企业智库 + 增长铁军
这不是四个功能的相加,而是一家企业在 AI 时代经营品牌与生意所需的全部:品牌战略回答"我是谁、往哪打"——以定位为基准,首创"业务方向"层,把老板的雄心翻译成这周打哪几仗、每仗讲什么;GEO 是 AI 时代的主战场——当客户不再翻搜索页、而是直接问 AI"选哪家",你必须被看见、被信任、被第一个推荐;企业智库是底座——企业全部家当沉淀为组织资产,只属于公司,不随员工流动;增长铁军是执行——一支不下班、不离职的 AI 部队,自动写、自动发、自动复盘,还替你找客户、找供应商、找市场答案。
战略定方向,智库做底座,GEO 打名声,铁军做生意。过去要养四个部门、请四家乙方的事,第一次长在同一个系统里;名声和生意,第一次在同一个闭环里互相滋养。老板最终只剩两件不可替代的事:定方向,看战报。