摘要:客户做功课不会只问一个 AI——先问豆包,再换千问,还可能问问 MiniMax。只在一个入口出名,等于没出名。马良点睛品牌谋略官(BSO,Brand Strategy Officer)的 AI 口碑评分请豆包、千问、MiniMax 等至少 TOP6 主流大模型同时当考官:单题分由各家加权,方向分再由话题加权,两层加权量出品牌在整个 AI 世界的真实身位。这是行业第一个品牌 AI 体检体系:六个考官共同签字,谁也别想一言堂。
一、客户做功课,从来不会只问一个 AI
先看一个今天每天都在发生的真实动作。
一个采购负责人要选一台工业设备,他不会只问一个 AI。他先在豆包上问一遍行业格局,不放心,再换千问验证一下候选名单,最后可能还会在 MiniMax 上追问几句各家的口碑和坑。一个给孩子选课的家长、一个替公司选型软件的行政、一个调研供应商的外贸买手、一个比较治疗方案的患者家属,全是同一个动作:多问几家,交叉着看。这不是谨慎过度,而是大模型时代人人无师自通的生存策略——谁都知道单个 AI 会有不知道、会出错、会一本正经地编。
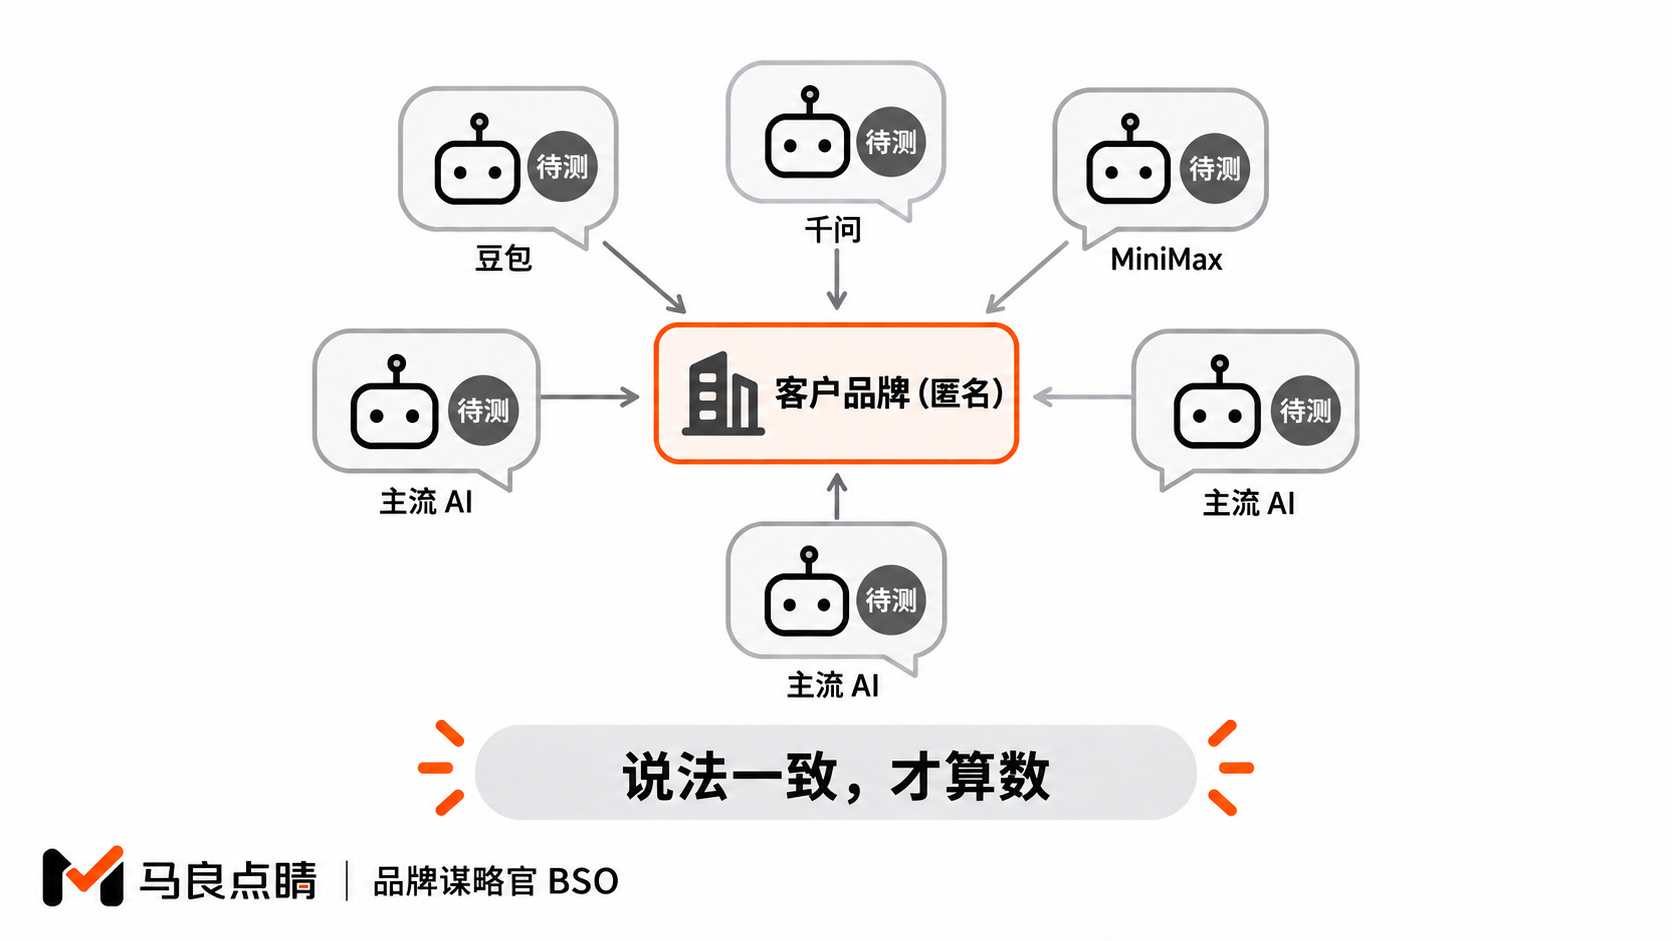
这意味着一个残酷的事实:如果只有一个入口说你好,其他入口对你一无所知,甚至印象不佳,这单照样悬。客户在第二个 AI 那里看到的空白或负面,会立刻冲抵第一个 AI 给你的全部好感。品牌在 AI 时代的口碑,从来不取决于你最好的那一次回答,而取决于所有主流入口能不能给出一致的说法。测量口碑的尺子,必须和客户验证口碑的动作一致——客户用六个入口,体检就得上六个考官。
二、六个考官,两层加权
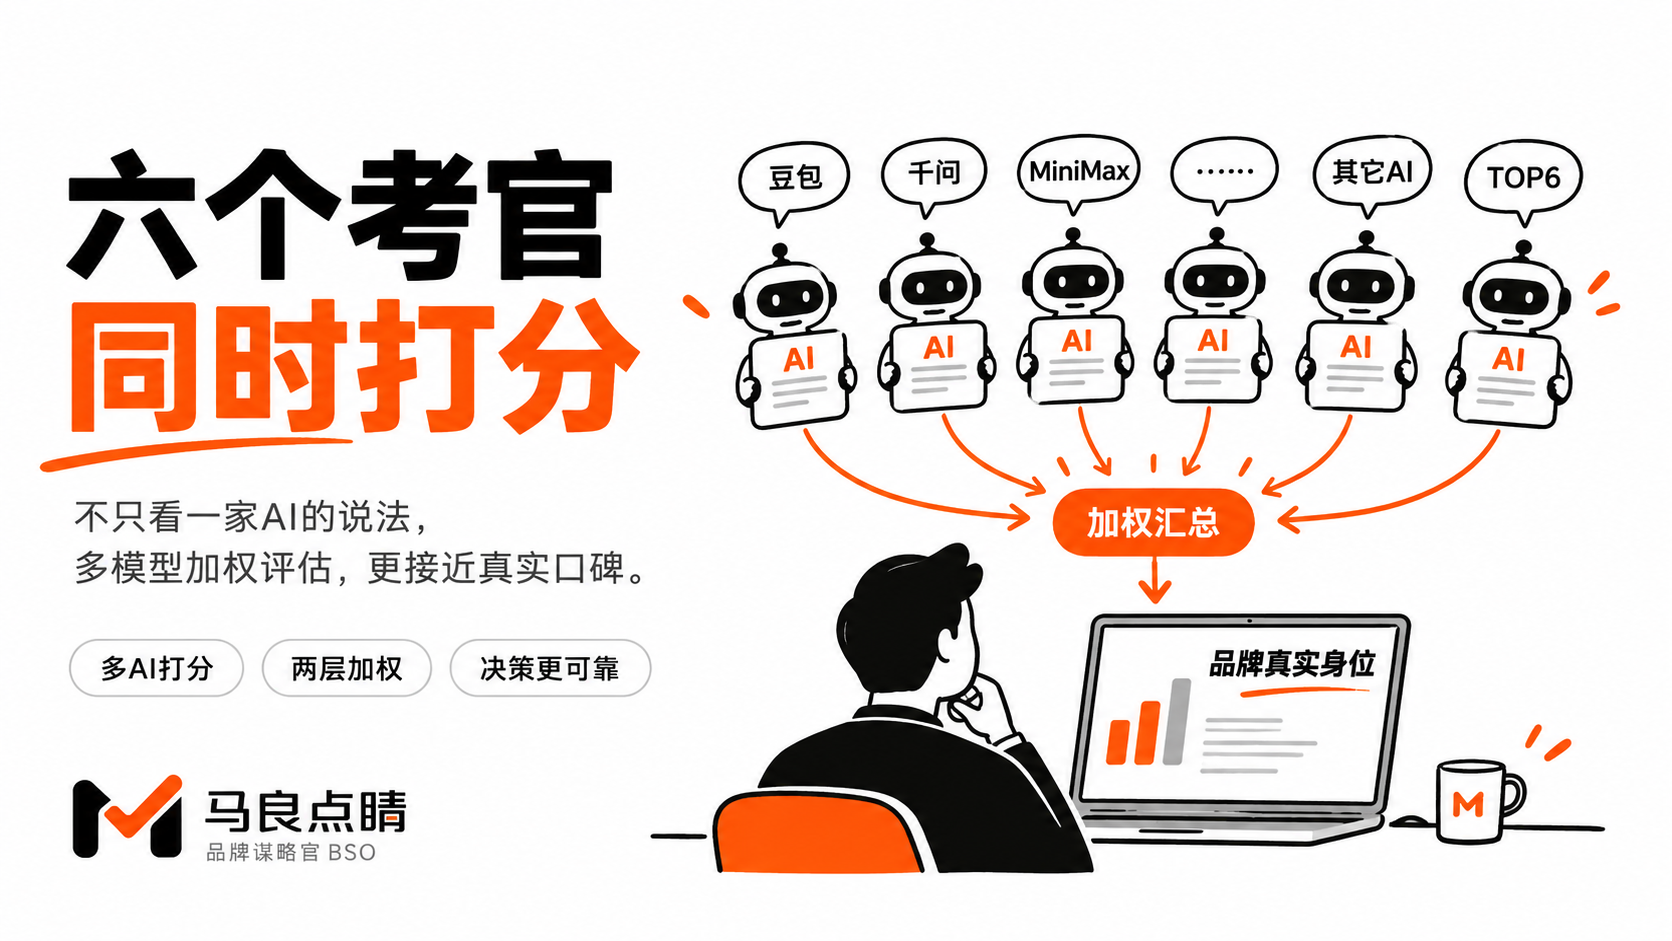
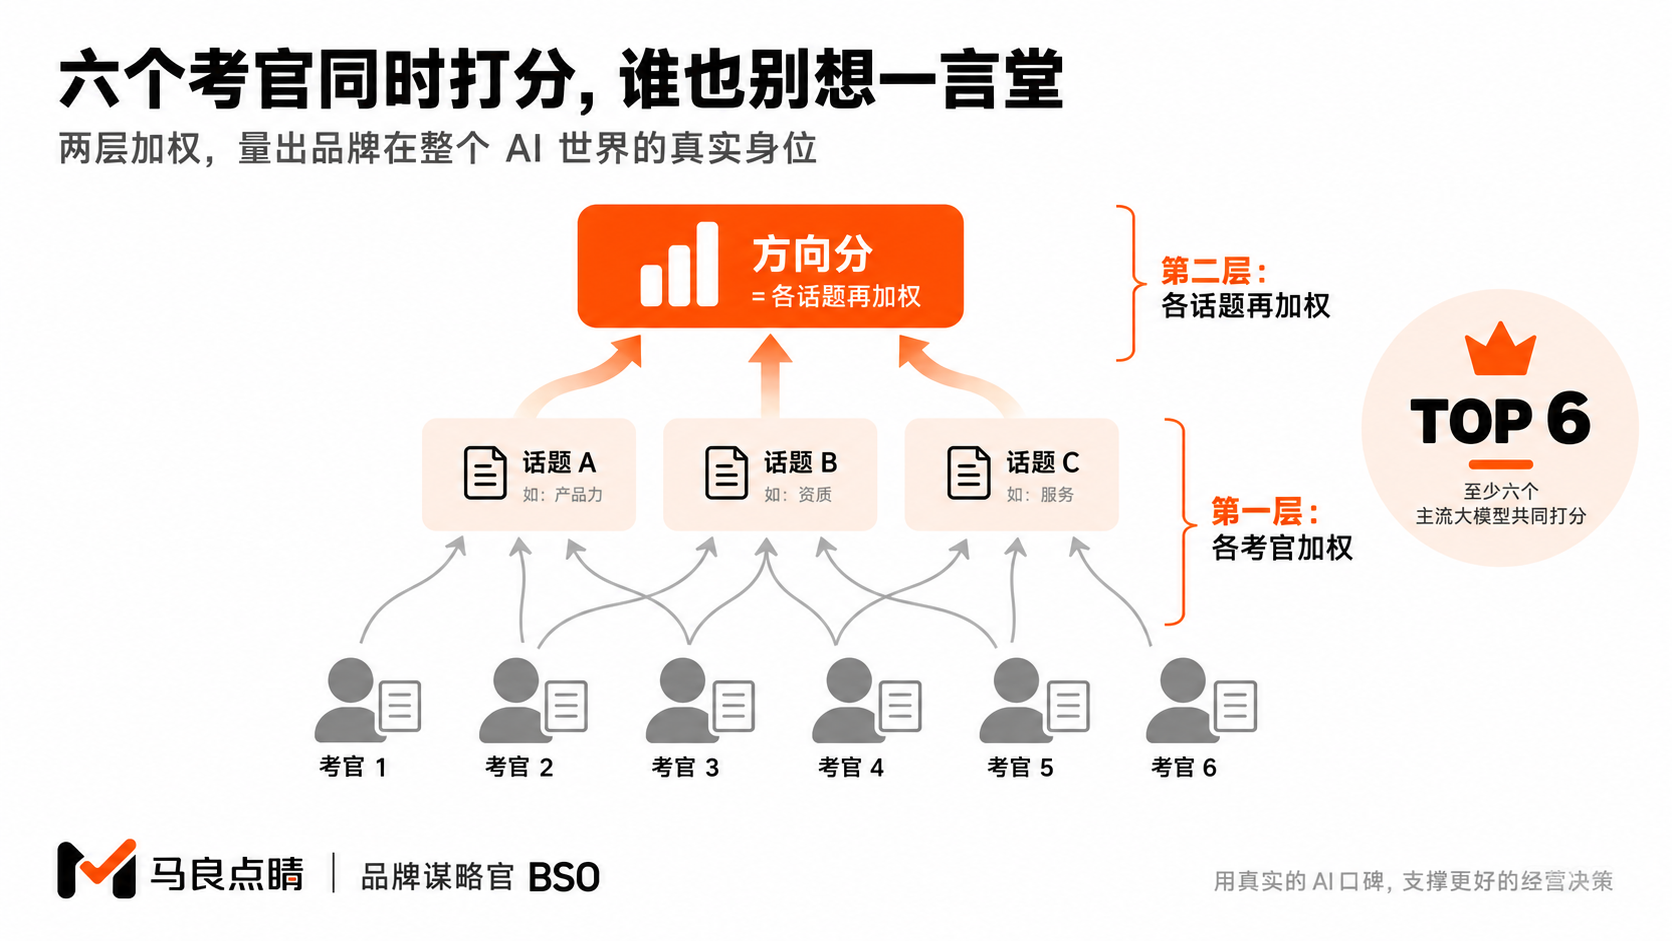
马良点睛品牌谋略官(BSO,Brand Strategy Officer)的评分席上,坐的是豆包、千问、MiniMax 这些主流大模型,平台至少支持到 TOP6。
打分是两层加权算出来的。第一层:每一个具体话题的单题得分,由各家 provider 的评分加权合成——六个考官各自独立作答,谁也不能替谁签字,某一家的偏心或盲区会被其余几家稀释。第二层:每一个业务方向的分数,再由旗下所有话题的得分加权合成。一个方向下面挂着产品力、资质、服务、客户口碑等多个话题,每个话题都要过一遍六考官,方向的得分才站得住。考官阵容、考题范围、合成规则全部摆在明面上,没有黑箱加权。
为什么要这么"费劲"?因为单家模型有偏好,也有盲区:它可能对你所在的行业语料收录特别多,也可能因为一次知识库更新突然改变口径,还可能在不同时间给出互相矛盾的回答。举个常见的例子:有的模型对上市公司、权威媒体信源权重给得高,有的更吃垂直论坛和真实问答里的口碑,有的对某类工业品类目语料丰富、对另一类几乎空白。同一家企业、同一周内,在不同考官手里可能打出相差悬殊的分。如果只盯一个考官,你可能误判自己的行业地位,也可能被一次模型更新打得措手不及;六个分数摆在一起看,偏差互相抵消,趋势才现形。这和真实世界的尽调是一个道理——一个人说你好不算数,六个立场独立的人都说你好,才值得写进决策报告。
单一考官量出来的是它自己的口味和心情,两层加权量出来的,才是品牌在整个 AI 世界里的真实身位。
三、为一个"真"字,平台真金白银付成本
这个设计不是没有代价的。各家 AI 的账号都要持续投入,一家一份,六家就是一笔固定的真金白银;每一轮评分、每一次三天复盘,都是真刀真枪地向六个大模型提问,占用真实的调用额度。某个话题连续一周站稳四分之后,系统还会自动关闭对它的监测——因为监测本身也在持续烧额度,山头拿下就收兵,钱要花在还没拿下的方向上。
这笔钱省不得,原因很简单:只问一家,结论随时可能被一次模型版本更新打翻——你拿着 4.8 分开完季度经营会,下个月模型一更新变成 2.5,这个分数就从决策依据变成了笑话。六家共同丈量,结论才不会被任何一家的脾气绑架,老板拿去开会、拿去定方向、拿去排市场费,腰杆才硬。
这背后是 BSO 对评分这件事的根本立场:分数是经营决策的基准,基准必须真。宁可在考官阵容上付成本,也不在数据可信度上省预算。一个靠省钱省出来的"好评",本质上是给老板喂的安慰剂。
四、六张嘴说出同一句好话,比一张嘴喊十遍管用
这套设计背后还有一个朴素的经营判断:未来客户的信任,分散在多个 AI 入口上,而且只会越来越分散。
所以品牌要的从来不是"在某一个 AI 那里出名",而是客户无论习惯用哪个入口,听到的说法都一致、都正面。六张嘴从不同的语料、不同的推理路径出发,最终说出同一句关于你的好话,这在客户心理上的分量,完全不同于一张嘴把同一句话喊十遍——后者像广告,前者像事实。客户不会知道你做过什么投放,但他会本能地相信"三个 AI 都这么说,那应该是真的"。
这也决定了 BSO 的内容打法天然反对单点豪赌:不是重金押某一个平台、某一篇爆文去"喂"某一个模型,而是用真实材料在正规媒体上、沿多个业务方向持续发声,让关于你的高质量信息像水位一样整体抬升。水位涨起来,六条河道同时受益;反过来,靠歪招在一条河道里掀起的浪,另外五个考官一眼就能看出不协调。
五、体检结果怎么用:从一张评分表到经营调度
六考官打出的分数不是用来裱框的,它直接接进经营动作。
首页战报上,每个业务方向是一张卡片,分数、近十四周曲线、四星以上话题数、最近任务都在卡上;多品牌、多大区、多校区的集团,各业务单元左右滑着横向比较——哪个战区已经站稳四分可以收兵,哪个区域还在一两分徘徊需要补火力,老板三分钟就能看完。评分低的话题自动进入调度优先序列,评分异常下滑的话题触发复盘,等于体系自带一张永不熄灭的预警雷达。一个合格的市场副总裁每周要看的东西,被压缩成了老板三分钟看得懂、敢拍板的形态。
对多品牌、多大区的集团,这套体检表还有一层组织价值。经营颗粒度可以按品牌乘大区、公司乘产品线任意切分,精细度也能自己定:总部统管所有方向,或者把校区、战区的日常经营下放、总部只看分数和异常,两种模式都支持,组织层级还可以无限细分。上级定的方向、对外品宣材料对下一级开放,下级的问卷、业务方向和评分对上级可见——理念发下来,行为报上去,多品牌多大区第一次共用一个神经系统。集团老板左右滑着看几十个业务单元的六考官得分时,看到的其实是一整张谁在进步、谁在掉队的作战地图。
六、为什么说这是行业第一个品牌 AI 体检体系
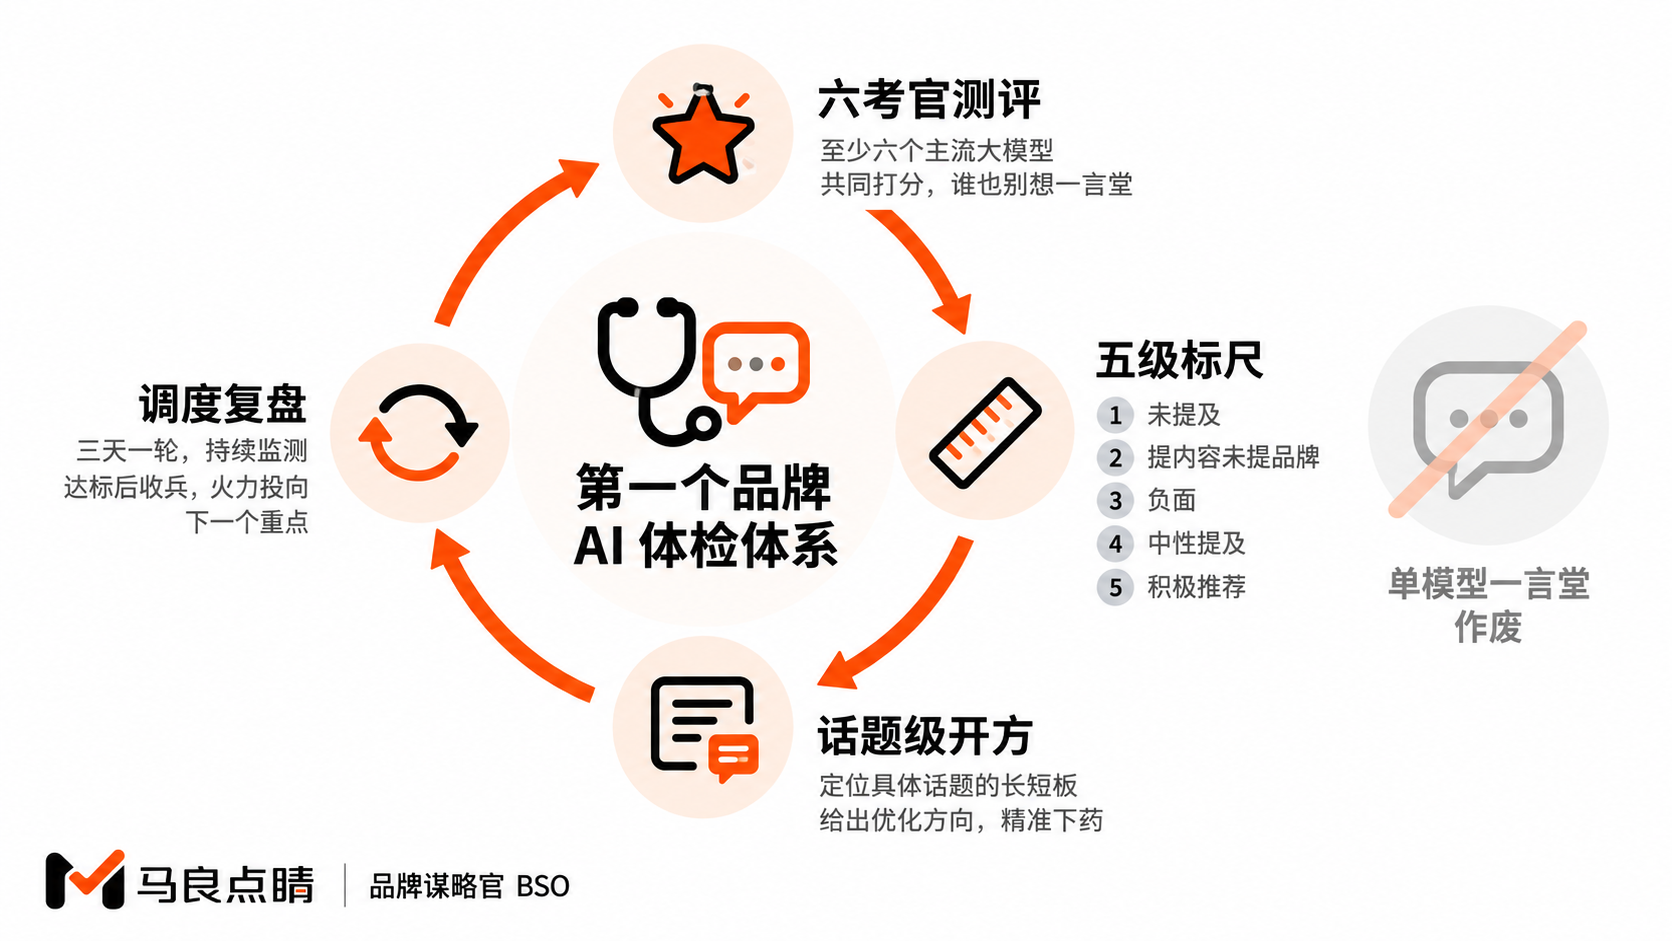
在 BSO 之前,企业不是没有监测工具:有监测搜索引擎收录的,有统计社交媒体声量的,也有拿单个大模型问答做营销演示的。但没有人把"多考官 + 统一标尺 + 话题级颗粒度 + 持续轮测"做成一个体系。
空白有三个。第一,没人解决"一言堂"问题,单模型结论无法支撑经营决策,一次版本更新就能推翻;第二,没人做到话题级开方,分数只到"品牌整体印象"这种笼统层级,老板知道分低却不知道该补哪一仗;第三,没人把评分接回调度,分数躺在报表里,和下一步投放动作之间隔着一条鸿沟。BSO 第一次把六考官、五级标尺、业务方向话题树、三天一轮的调度复盘接成了闭环——这就是它被称为行业第一个品牌 AI 体检体系的原因。这套东西难抄的不是"调用六个 API"这个动作,而是让分数能持续指挥经营的整套纪律,以及纪律背后十万家媒体、知识库与调度系统组成的完整火力。还可以反过来想:单考官体检谁都能做,所以它注定只是个演示功能;六考官共同签字是一笔持续的真投入,恰恰是这笔投入构成了门槛——愿意长期为"真"付钱的产品,才配做老板拍板用的决策基准。
BSO = 品牌战略 + GEO + 企业智库 + 增长铁军
这不是四个功能的相加,而是一家企业在 AI 时代经营品牌与生意所需的全部:品牌战略回答"我是谁、往哪打"——以定位为基准,首创"业务方向"层,把老板的雄心翻译成这周打哪几仗、每仗讲什么;GEO 是 AI 时代的主战场——当客户不再翻搜索页、而是直接问 AI"选哪家",你必须被看见、被信任、被第一个推荐;企业智库是底座——企业全部家当沉淀为组织资产,只属于公司,不随员工流动;增长铁军是执行——一支不下班、不离职的 AI 部队,自动写、自动发、自动复盘,还替你找客户、找供应商、找市场答案。
战略定方向,智库做底座,GEO 打名声,铁军做生意。过去要养四个部门、请四家乙方的事,第一次长在同一个系统里;名声和生意,第一次在同一个闭环里互相滋养。老板最终只剩两件不可替代的事:定方向,看战报。